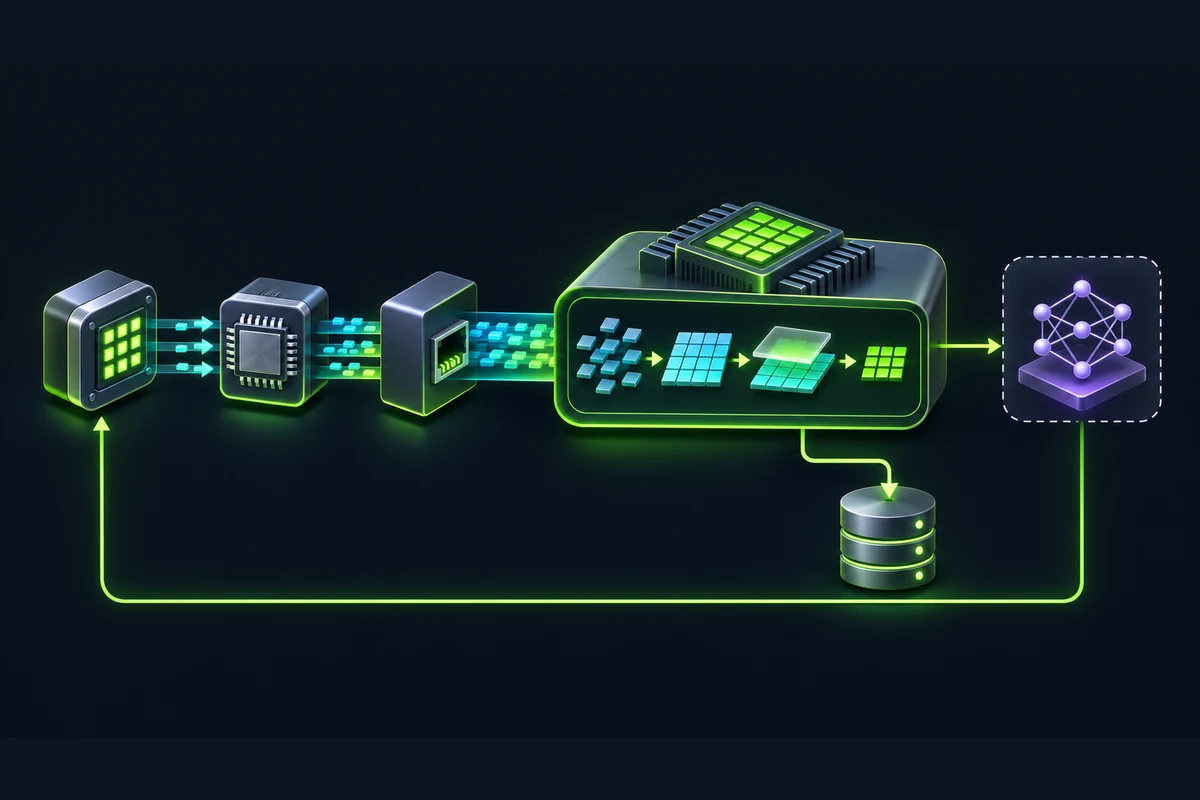
Le 19 novembre, NVIDIA a décrit une caméra de microscopie électronique à haute plage dynamique du Molecular Foundry du Lawrence Berkeley National Laboratory, reliée au traitement GPU par sa bibliothèque d’acquisition DAQIRI. L’instrument peut émettre plus de 500 gigabits par seconde lorsqu’il mesure la perte d’énergie des électrons, un débit que NVIDIA dit supérieur de plus de 500 fois aux flux EELS conventionnels. Le FPGA de lecture envoie les données par Ethernet vers une interface réseau ConnectX ; DAQIRI place la charge dans une mémoire accessible au GPU, qui assemble les images, corrige le détecteur, réduit les spectres et les visualise pendant l’expérience. NVIDIA annonce aussi le réordonnancement matériel des paquets, un backend ibverbs et une interrogation directe pour les flux de contrôle à faible latence. Rapport NVIDIA sur DAQIRI et la microscopie
Le changement central tient à l’emplacement du calcul. Une chaîne d’instrument classique capture les données brutes, les stocke, puis les envoie à une station de travail ou à un centre de calcul. À très haut débit, stockage et transfert retardent le retour d’information ou obligent à jeter ou réduire des données avant que les chercheurs aient pu déterminer ce qui importe. DAQIRI place la mémoire GPU dans le chemin d’acquisition. Le logiciel peut alors examiner et réduire les données pendant l’expérience, voire ajuster des réglages avant la décision d’acquisition suivante. Cette possibilité compte, mais il faut la distinguer de ce que montre le cas Berkeley et des fonctions qui demeurent des capacités de plateforme plutôt que des résultats AI observés.
Le détecteur impose un problème de chemin de données#
La spectroscopie des pertes d’énergie d’électrons, ou EELS, mesure l’énergie que perdent des électrons en interagissant avec un échantillon. Les spectres aident à identifier les éléments présents et leurs liaisons. Ils contiennent des signaux intenses et faibles. Selon NVIDIA, la méthode classique utilise deux acquisitions rapides successives, chacune optimisée pour une plage d’intensité. Il faut coordonner précisément optique électronique, durée d’exposition et lecture du détecteur ; les deux résultats doivent ensuite être alignés et combinés, ce qui complique acquisition et traitement. Un détecteur à grande plage dynamique capture une plage d’intensité plus vaste en une acquisition, simplifiant optique et synchronisation mais produisant beaucoup plus de données par unité de temps. NVIDIA sur le workflow de la caméra EELS
Plus de 500 Gbit/s ne constitue pas seulement un chiffre de réseau. Divisé par huit, cela représente au moins 62,5 gigaoctets par seconde pendant le flux. S’il était maintenu en continu, le débit atteindrait environ 225 téraoctets par heure et 5,4 pétaoctets par jour, avant frais de protocole ou réduction. Ce calcul explique pourquoi « tout enregistrer puis regarder » peut devenir impraticable. Il ne signifie pas que ce microscope fonctionne sans interruption à ce débit toute la journée. L’acquisition peut se faire par séquences et le traitement aval peut réduire ou sélectionner les mesures à conserver.
La caméra, le FPGA de lecture, les liens Ethernet, l’interface réseau et le logiciel constituent une seule chaîne d’acquisition. Les données du détecteur ne sont utiles que si les étapes suivantes les reçoivent sans perte, reconstruisent les images et calculent les résultats avant la suite de l’expérience. En cas de perte de paquets ou de débordement de tampon, le GPU ne peut reconstituer les mesures manquantes. Si les données arrivent intactes mais dans le désordre, le système doit les trier avant de former des images exploitables. Si le traitement attend l’écriture complète sur disque, les informations risquent d’arriver trop tard pour influencer l’expérience.
Le transport des données fait donc partie de la conception expérimentale. Les scientifiques choisissent exposition, balayage et régions d’intérêt en fonction de l’échantillon et du détecteur. Une nouvelle caméra à grande plage dynamique peut révéler à la fois des signaux autrefois masqués et ceux qui nécessitaient des passes séparées. Mais ces détails supplémentaires n’ont de valeur que si la chaîne d’acquisition rend les résultats disponibles à temps. La question n’est pas seulement de savoir si la caméra capture plus, mais si ces informations peuvent parvenir aux chercheurs alors qu’ils peuvent encore modifier la prochaine mesure.
Le laboratoire Berkeley a déjà un précédent proche, avec un autre instrument et une autre chaîne de données. Berkeley indique que sa 4D Camera fonctionne à 87 000 images par seconde et peut générer jusqu’à 700 Go en 15 secondes. Le workflow existant utilise des serveurs de réception reliés par FPGA, ingère les données dans la RAM, les écrit sur flash, puis les traite sur place ou les transfère aux ressources HPC du NERSC. Le laboratoire affirme que le flux de données a réduit le délai de traitement et permis des décisions en temps réel. Cela montre l’intérêt d’acquérir plus vite les données de microscopie, mais ne doit pas être confondu avec la caméra EELS à plus de 500 Gbit/s ou la chaîne DAQIRI de 2026. Workflow de la 4D Camera de Berkeley · Département américain de l’Énergie sur l’analyse en temps réel des détecteurs
Le nouveau système modifie l’endroit où une partie du calcul peut se dérouler. Les écritures flash et le transfert vers le calcul central restent utiles pour conserver des archives et accéder à de plus grandes ressources. Le chemin DAQIRI permet de traiter certaines opérations en périphérie avant ou pendant ces étapes. Il s’agit donc plutôt d’une architecture complémentaire que du simple remplacement des disques ou du HPC. Le scientifique peut avoir besoin des données brutes pour les réexaminer, tout en utilisant des réductions en direct pour ajuster les paramètres. La décision de conserver, réduire ou écarter des éléments dépend de la reproductibilité scientifique et du protocole expérimental.
DAQIRI dirige l’acquisition vers le GPU#
DAQIRI signifie Data Acquisition for Integrated Real-time Instruments. NVIDIA la décrit comme une bibliothèque définie par logiciel qui alimente en données à haut débit des workflows prêts pour GPU. Avec du matériel compatible, elle accède à l’interface réseau en espace utilisateur, contourne la pile réseau du noyau Linux et utilise GPUDirect pour les transferts entre carte réseau et GPU sans copie intermédiaire pilotée par le CPU. Son API prend en charge C++ et Python. DAQIRI fait partie de l’écosystème Holoscan, consacré aux traitements de capteurs en flux et aux applications d’IA temps réel. Dépôt et documentation NVIDIA DAQIRI · Présentation développeur DAQIRI
« Acquisition GPU-native » ne signifie pas que le GPU remplace le microscope ou toute l’électronique de lecture. Dans le cas Berkeley, caméra et FPGA continuent l’acquisition et la mise en forme des données. Ethernet transmet les paquets vers une interface compatible. DAQIRI gère transfert, ordre et placement mémoire. Des kernels GPU assemblent ensuite les images et corrigent le détecteur avant de réduire les données en spectres EELS. NVIDIA dit que le calcul récupère une information spatiale inférieure au micron à partir de pixels de capteur de cinq microns. Le système combine plusieurs composants spécialisés ; DAQIRI relie mesure et traitement accéléré.
La notion de « zéro copie » a aussi une limite. Elle désigne l’évitement de copies supplémentaires dans un chemin compatible, par exemple l’écriture directe de la charge réseau en mémoire accessible au GPU. Elle ne supprime pas tampons, analyse des paquets, réordonnancement, correction du détecteur, conversion ou stockage ultérieur. Certaines étapes peuvent volontairement copier ou convertir les données, et les modes de transfert dépendent de la présence d’un GPU discret ou d’une mémoire unifiée. Le zéro-copie peut réduire les frais CPU et mémoire, mais le débit de bout en bout dépend toujours des kernels GPU, du format du détecteur, des files, du trafic et de l’ordonnancement logiciel.
La compatibilité matérielle est circonscrite. Le dépôt DAQIRI précise que les chemins à hautes performances Raw Ethernet, RoCE et GPUDirect exigent un NIC NVIDIA ConnectX-6 Dx ou ultérieur et un GPU CUDA pris en charge. Le projet cite notamment DGX Spark, IGX et RTX Pro Servers. Une voie Linux Sockets fonctionne avec du matériel plus modeste, sans offrir le même profil de performance maximale. D’après la documentation actuelle, le pacing des paquets, l’émission temporisée précise et le réordonnancement matériel exigent ConnectX-7 ou ultérieur. « GPU-native » désigne donc une option d’architecture pour des systèmes compatibles, pas un gain logiciel disponible sur tout poste de travail. Configuration requise DAQIRI · Configuration matérielle DAQIRI
Le chemin de données diffère entre plateformes à GPU discret et intégré. Le guide système de NVIDIA décrit les systèmes IGX avec GPU discret, BAR1 GPU distinct et liaison PCIe entre NIC et GPU. DGX Spark repose sur la puce GB10 avec mémoire CPU/GPU unifiée et ConnectX-7 intégré ; son mode GPUDirect utilise des tampons host-pinned. Ces différences comptent pour interpréter les benchmarks. Deux systèmes décrits comme « directs vers le GPU » peuvent reposer sur des topologies mémoire et des transports distincts, avec des effets sur latence et débit.
Les options logicielles changent aussi le comportement. DAQIRI prend en charge Raw Ethernet, RoCE/RDMA et sockets Linux, différents moteurs de réception, un réordonnancement CPU ou GPU et plusieurs placements de buffers. Les développeurs configurent interfaces, files, flux et régions mémoire. La sortie n’est pas un mode unique qui rend automatiquement tout flux temps réel. Il faut choisir transport et files adaptés à l’instrument, régler hôte et réseau, puis valider perte de paquets, pression mémoire et pipeline sous charge réelle. Le guide d’installation NVIDIA recommande lui-même de construire la bibliothèque, optimiser l’hôte si nécessaire et lancer un benchmark sur la machine cible. Guide de démarrage DAQIRI · Guide API DAQIRI
Trois nouveautés ciblent des goulots distincts#
La version de novembre ajoute le réordonnancement matériel des paquets sur les cartes réseau ConnectX-7 ou ultérieures prises en charge. Les réseaux peuvent livrer les paquets dans le désordre et leur traitement logiciel classique ajoute travail CPU, mémoire et latence. Pour des formats de paquets compatibles, le NIC analyse les numéros de séquence et place les charges dans le bon ordre directement en mémoire. L’application reçoit alors un tampon ordonné sans étape logicielle distincte de réordonnancement et de copie. La configuration doit indiquer l’emplacement des numéros de séquence et la réaction aux paquets manquants. Il s’agit d’une fonction sur une file précise, pas d’une garantie d’absence de pertes ni de compatibilité de tous les instruments. Description NVIDIA du réordonnancement matériel
La deuxième nouveauté est un moteur ibverbs pour l’émission et la réception rapides de paquets Raw Ethernet. NVIDIA dit qu’il réduit le coût CPU par paquet et double presque le débit par cœur face à l’ancien backend DPDK par défaut pour des paquets allant jusqu’à 1 024 octets à des débits supérieurs à 200 Gbit/s. Les essais ont été effectués sur DGX Spark, IGX Thor et RTX Pro Servers. La figure 3 montre un résultat mono-file sur IGX Thor, avec des performances similaires attendues sur DGX Spark et x86. Les résultats sur des paquets de 8 Ko sont proches. Le bénéfice dépend donc de la taille des paquets et des conditions de comparaison, pas d’un doublement général de la bande passante. Conditions du benchmark ibverbs NVIDIA
La troisième fonction, direct polling, vise les messages de contrôle sensibles à la latence. Avec un worker I/O distinct du thread applicatif, soumettre et recevoir des paquets nécessite un transfert entre threads. Le polling direct permet à l’application de le faire elle-même, supprimant ce passage. NVIDIA rapporte 2 à 4 microsecondes entre envoi et réception lors d’un test loopback câblé entre deux ports du même hôte. C’est un microbenchmark réseau local, pas la latence complète entre mesure par caméra, analyse GPU et réglage de l’instrument. La boucle complète comprend lecture du détecteur, mise en paquets, ordonnancement, calcul GPU, décision et réponse de contrôle. Le chiffre en microsecondes n’en décrit qu’un segment. Test direct polling de NVIDIA
Ces fonctions peuvent être combinées de façon ciblée. Une file de mesures à haut débit peut utiliser le réordonnancement matériel, tandis qu’une file de contrôle plus petite utilise direct polling. Le traitement en lots privilégie le débit ; un autre réglage traite les messages de retour sensibles au délai. Cela reflète deux besoins différents : recevoir un gros flux efficacement et envoyer une commande à temps. L’une des optimisations peut contrarier l’autre ; il faut les mesurer sous contention réaliste plutôt que d’assimiler une seule latence minimale aux performances de l’instrument entier.
Le cas EELS montre du traitement d’image, pas une boucle d’IA démontrée#
NVIDIA présente DAQIRI comme une infrastructure pour l’IA temps réel appliquée aux instruments et dit que la bibliothèque permet analyse et retour de contrôle. Le cas EELS de Berkeley démontre acquisition à grande vitesse et traitement GPU pendant la mesure. Les étapes GPU mentionnées sont assemblage des images, correction du détecteur, réduction spectrale et visualisation. L’article ne nomme pas de modèle d’IA commandant ce microscope et ne rapporte ni score d’IA ni résultat d’autocontrôle pour cette caméra. Étude de cas de Berkeley par NVIDIA
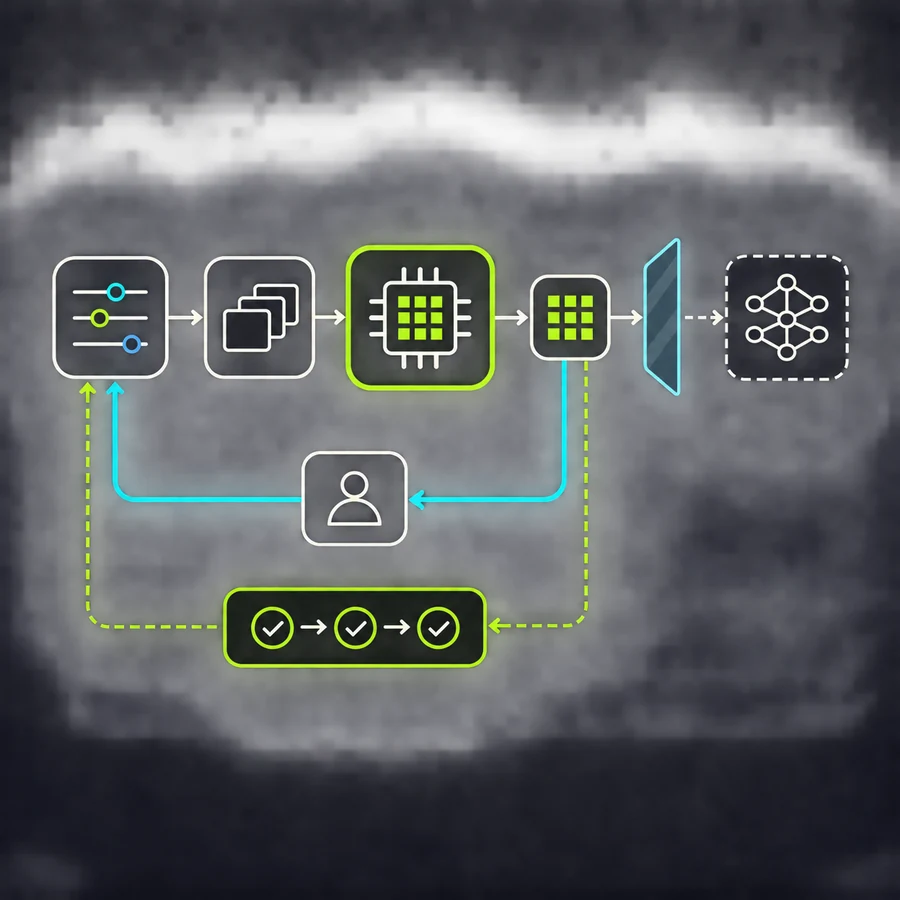
Cette distinction compte, car une pipeline GPU n’est pas synonyme d’inférence par un modèle d’IA. Des kernels GPU peuvent exécuter des corrections, transformations et réductions déterministes sans inference. Holoscan et TensorRT peuvent héberger des applications IA en flux en aval ; DAQIRI peut leur préparer les données. L’histoire de plateforme NVIDIA est que le chemin d’acquisition peut rendre l’IA temps réel possible. Dans le workflow EELS décrit, le résultat rapporté est le traitement et la visualisation des données pendant que l’acquisition continue. Toute affirmation de découverte scientifique ou d’ajustement d’expérience piloté par l’IA exigerait une description et des preuves distinctes.
Cette limite clarifie aussi le retour d’information. Pendant la mesure, les chercheurs peuvent examiner les données et modifier paramètres ou régions d’intérêt. C’est une possibilité d’intervention humaine en boucle. Un contrôle autonome devrait en plus détecter une condition, décider du réglage, appliquer la modification sans risque et vérifier la mesure suivante. L’article parle de possibilités de retour de contrôle et de commandes sensibles au temps, mais son exemple EELS ne décrit pas un système où l’IA décide comment piloter le microscope. L’architecture peut servir à développer cela ; le cas publié ne l’a pas encore démontré.
La comparaison « plus de 500 fois plus rapide que l’EELS conventionnel » reste une affirmation de NVIDIA liée aux flux qu’elle compare. L’article explique que la méthode classique optimise séparément les acquisitions de signaux faibles et forts, mais ne définit pas complètement l’instrument conventionnel, le détecteur, la durée d’acquisition et la frontière de traitement derrière le facteur 500. Le nombre donne une échelle et doit être attribué à NVIDIA, sans être présenté comme un ratio sectoriel audité indépendamment.
Des recherches indépendantes en microscopie montrent pourquoi le traitement rapide importe depuis longtemps. Le projet Berkeley 4D Camera fonctionne à 87 000 images/seconde et peut produire 700 Go en moins de 15 secondes. Son workflow existant ingère en RAM, écrit sur flash, puis traite sur place ou transfère au NERSC. Le laboratoire indique que l’approche en flux a amélioré le délai de traitement et permis des décisions pendant l’expérience. Une étude de 2025 sur la microscopie en flux décrit aussi les défis de stockage et de traitement de grandes données, ainsi que la chaîne FPGA-réception-mémoire-stockage. Ces travaux ne mesurent ni la nouvelle caméra EELS ni DAQIRI ; ils montrent que débit des détecteurs et latence d’analyse influencent déjà la conception des instruments. Workflow 4D Camera de Berkeley Lab · Étude sur le streaming de données de microscopie
Le nouveau système déplace certains traitements. Écriture flash et transfert vers un calcul central demeurent utiles pour préserver les données et accéder à de plus grandes ressources. DAQIRI permet d’exécuter certaines opérations en périphérie avant ou pendant ces étapes. Il s’agit donc d’une architecture complémentaire, pas du remplacement simple des disques ou du HPC. Les scientifiques peuvent avoir besoin des données brutes pour une réanalyse ultérieure et des réductions en direct pour modifier immédiatement des paramètres. Le choix de stockage, de réduction ou de suppression dépend du protocole scientifique et de la reproductibilité.
Le traitement en direct modifie les choix expérimentaux#
Voir les mesures pendant l’acquisition peut révéler un problème plus tôt. Un signal inattendu, un défaut du détecteur ou une région d’intérêt mal choisie peut apparaître avant la fin d’une longue acquisition. Le gain potentiel ne concerne pas seulement la vitesse de post-traitement ; il s’agit aussi d’éviter de collecter des données inutiles. Lorsque le temps machine est rare ou l’échantillon fragile, un avertissement précoce peut changer la mesure suivante. C’est l’intérêt de rapprocher l’analyse du détecteur.
Il y a un compromis entre agir rapidement et préserver les éléments nécessaires ensuite. Une réduction en direct peut livrer un spectre utile rapidement, mais le flux brut peut contenir des détails récupérables par un futur algorithme. Si les données sont éliminées pour tenir le débit, le protocole doit expliquer ce qui a été réduit et pourquoi. Si le flux brut est aussi conservé, les besoins de stockage et de réseau restent. « Traiter avant le disque » peut soulager certains workflows, sans supprimer la gestion des données.
Un chemin d’acquisition GPU-native peut également amener les fabricants à revoir la lecture des détecteurs. NVIDIA suggère qu’une caméra capturant ensemble signaux intenses et faibles pourrait simplifier l’optique et la coordination autrefois nécessaires à deux passes. Mais le système exige toujours une électronique de détection et un FPGA capables de suivre le débit, ainsi qu’un réseau et des ressources calcul suffisants. Une liaison rapide ne fait parfois que déplacer le goulot : si assemblage GPU ou extraction spectrale prend du retard, les files croissent ou l’acquisition doit ralentir.
Pour un instrument avec retour de contrôle, la mesure la plus importante est la latence de bout en bout sous charge. Le loopback de 2 à 4 microsecondes ne suffit pas. Il faut mesurer du signal du détecteur à une métrique scientifique validée, puis jusqu’à la décision et à l’action de l’instrument. Il faut aussi surveiller jitter et perte de paquets, pas seulement le débit moyen. La caméra peut émettre par salves plus rapides que son débit moyen et la queue de latence peut affecter les commandes. Ces mesures diront si la chaîne peut orienter l’acquisition en sécurité plutôt qu’afficher un aperçu.
Le retour scientifique exige des garde-fous. Un modèle ou un algorithme ne devrait pas modifier une mesure importante parce qu’une image semble anormale. L’application peut imposer seuils de confiance, limites de changement et confirmation humaine. Les journaux devraient conserver mesure brute, signal dérivé, version logicielle et action choisie. Sans provenance, un retour plus rapide peut rendre l’expérience moins reproductible. Le chemin basse latence est utile s’il fournit des éléments plus tôt tout en laissant la chaîne de preuve vérifiable.
Ce que montrent les chiffres, et ce qu’ils ne montrent pas#
Les nombres de débit dépendent de la taille des paquets, des files, du matériel et des versions de backend. Le résultat ibverbs compare le débit par cœur pour petits paquets à plus de 200 Gbit/s ; les gros paquets de 8 Ko sont indiqués comme similaires. La latence direct polling vient d’un loopback câblé sur un hôte. Le flux de la caméra Berkeley est un cas différent, à plus de 500 Gbit/s. Ces résultats ne répondent pas à la même question et ne prouvent pas une boucle de contrôle IA à quatre microsecondes pour un microscope débitant 500 Gbit/s.
Il faut commencer les essais sur le système cible. La documentation DAQIRI précise Linux, cartes réseau/GPU prises en charge, dépendances CUDA et hugepages ; elle indique que le conteneur contient DPDK modifié et les dépendances réseau. Les meilleures performances GPUDirect exigent du matériel compatible. Le chemin Linux socket fonctionne sur des équipements plus modestes, mais ce n’est pas le chemin rapide équivalent. Cela détermine qui peut l’adopter et quels achats ou développements seront nécessaires. Configuration matérielle et logicielle DAQIRI
L’article de NVIDIA conseille d’utiliser les benchmarks DAQIRI pour mesurer débit et latence de communication sur le matériel cible. Un test utile doit utiliser le format exact des paquets de l’instrument, tester l’ordre d’arrivée, les salves d’acquisition, les kernels, le stockage et la cadence de retour. Il faut aussi tester surcharge et récupération de paquets manquants. Le réordonnancement matériel nécessite un NIC compatible et un format de séquence pris en charge ; la politique de délai peut supprimer des lots incomplets. Ces choix touchent l’intégrité scientifique, pas seulement la vitesse.
Un benchmark propre pourrait comparer les variantes de pipeline : réception et copie classiques, transfert GPUDirect, réordonnancement logiciel ou matériel, traitement en lots et polling direct du contrôle. Il faut garder le détecteur et l’analyse fixes en changeant une seule couche à la fois. Une fonction matérielle complexe peut ne rien apporter aux paquets volumineux ; le polling direct peut réduire le délai de commande tout en monopolisant un cœur applicatif. Ces résultats sont utiles : l’objectif n’est pas d’activer par défaut chaque nouveauté.
La décision de conserver les mesures brutes ou de les réduire en périphérie doit être évaluée séparément du débit réseau. Certaines expériences ont seulement besoin de spectres choisis pour agir en direct. D’autres exigent le brut pour audit, recalibrage ou nouvelle analyse. Même si DAQIRI transmet les octets directement au GPU, elle ne peut décider quelles preuves scientifiques sont sûres à supprimer. Cette frontière dépend du protocole et des analyses ultérieures.
Quelles preuves rendraient le prochain résultat convaincant#
Le suivi le plus probant publierait un workflow complet de la nouvelle caméra avec DAQIRI, comprenant débit soutenu et en rafale, pertes, comportement GPU et stockage, latence de traitement et part des données brutes conservées. La comparaison avec l’EELS conventionnel derrière « 500 fois » devrait définir l’instrument et préciser si elle concerne la sortie détecteur, les images assemblées ou le spectre final. Les autres laboratoires pourraient alors interpréter le chiffre.
Pour le retour IA, un test distinct devrait nommer modèle ou algorithme, condition détectée, action autorisée et résultat par rapport à une vérité terrain ou à un protocole approuvé par des chercheurs. Il devrait couvrir faux négatifs, fausses alertes et échantillons inhabituels. Il faudrait savoir si le retour a amélioré le rendement expérimental ou réduit le temps sans sacrifier les données utiles à l’analyse ultérieure. Le transport prêt pour GPU fournit l’infrastructure, pas la validation de la méthode scientifique.
La reproductibilité demande également les détails logiciel et matériel : version DAQIRI, modèles de NIC et GPU, pilotes et CUDA, configuration des files, tailles de paquets, nombre de répétitions, variations d’échantillons et incertitude. Il faudrait distinguer ce qui est mesuré par NVIDIA, l’équipe instrumentale et des évaluateurs indépendants. L’article technique actuel décrit des détails d’ingénierie utiles, notamment les fonctions et le chemin des données ; une mesure indépendante établirait la généralité des résultats.
La question de l’écosystème compte également. DAQIRI est ouvert sous Apache 2.0 et possède des interfaces C++ et Python, mais les performances maximales nécessitent une carte réseau et un GPU NVIDIA compatibles. D’autres NIC peuvent emprunter la voie socket, tandis que les modes haut débit à zéro copie sont plus restreints. Les installations scientifiques combinent souvent anciens instruments, FPGA personnalisés et clusters partagés. Intégration, traitement des pannes et support durable pèseront autant que la bande passante annoncée. Dépôt source DAQIRI et chemins pris en charge
Chemin de mesure plus rapide, boucle IA à démontrer#
La mise à jour DAQIRI vise un problème concret : les données d’instruments à haut débit peuvent dépasser les possibilités d’une chaîne « stocker puis analyser ». Le microscope EELS de Berkeley donne un cas précis et le transfert GPU-native rend possible le traitement pendant l’acquisition. Réordonnancement matériel, ibverbs et polling direct ciblent différents goulots de la livraison de paquets et du contrôle. Les chiffres publiés restent attachés à leurs tailles de paquets, matériel et configuration de test.
Le lien avec l’IA relève de la plateforme. DAQIRI peut préparer les données pour le traitement GPU, l’inférence et le retour de contrôle, mais le workflow EELS décrit exécute assemblage d’images, correction du détecteur, réduction spectrale et visualisation ; il ne montre pas de modèle commandant le microscope de façon autonome. Les chercheurs peuvent voir les résultats et ajuster des réglages pendant la mesure. C’est utile, et distinct d’une expérience en boucle fermée évaluée.
Le résultat à suivre est la capacité du chemin d’acquisition à améliorer une décision de mesure de bout en bout. Des preuves fortes relieraient caméra, transport, analyse GPU et action de contrôle à un résultat scientifique reproductible, en documentant conservation des données brutes et modes de panne. Pour l’instant, DAQIRI est surtout une infrastructure qui rapproche l’analyse de l’instrument. La chaîne de données va vers l’IA ; le cas présenté démontre un accès plus rapide aux mesures.