L’ouverture aux développeurs a suivi un premier déploiement, la veille. Le 18 novembre, Google a commencé à proposer la nouvelle expérience Project Genie aux abonnés Google AI Ultra éligibles, tandis que les membres AI Pro pouvaient rejoindre une liste d’attente. Le 19 novembre, l’entreprise a annoncé que les développeurs pouvaient aussi utiliser Genie 4 via Gemini API et Google AI Studio. Le modèle passe donc d’une expérience interactive réservée à un abonnement à un workflow d’API avec cycle de session, transports, authentification et facturation à l’usage. Cela ne le transforme pas en moteur de jeu généraliste ni en simulateur physique persistant. Annonce de disponibilité développeur par Google · Déploiement de Project Genie par Google
L’offre concrète consiste à amorcer un monde avec du texte, une image de référence ou les deux, puis à envoyer des commandes clavier et des modifications textuelles pendant la réception d’une vidéo générée avec audio synchronisé. Le flux atteint 720p et 24 images par seconde. Google présente cette possibilité comme un moyen de tester des expériences interactives, des concepts spatiaux et des environnements d’entraînement d’agents. Les premières applications devront cependant composer avec des sessions courtes, un service hébergé aux États-Unis, le coût de génération et la dérive de l’état. Ces éléments détermineront si une démonstration visuellement forte devient une expérience produit utile. Documentation Interactions API de Genie 4
L’API offre une autre voie d’accès#
La mise à jour de Project Genie du 18 novembre et l’annonce développeur du 19 novembre s’adressent à des publics différents. La première fournit aux abonnés AI Ultra éligibles une expérience navigateur avec agent de création de mondes et galerie communautaire. La seconde donne accès aux développeurs via Gemini Interactions API et le canvas AI Studio. L’expérience grand public n’est pas une clé API, et l’API ne se résume pas à un lien vers la même interface d’abonnement. Les développeurs disposent désormais d’une voie prise en charge pour créer une session, connecter un client, envoyer des commandes au monde et arrêter la génération côté serveur. Google sur l’ouverture de Project Genie aux abonnés · Google sur l’accès à l’API
Cette différence change qui peut tester le système et ce qu’il peut contrôler. Dans Project Genie, l’abonné utilise l’expérience intégrée de Google pour créer, explorer et remixer un monde. Avec l’API, le développeur peut intégrer la session à un prototype, connecter des contrôles personnalisés et décider comment la vidéo et le son générés entrent dans l’application. AI Studio propose un canvas interactif et des applications de départ pour essayer le workflow avant de bâtir une intégration plus complète. Les deux parcours utilisent le même modèle mais ont des rôles distincts : l’un présente une expérience empaquetée, l’autre expose les mécanismes de session. Documentation Genie dans Google AI Studio
Google décrit Genie 4 comme un système de génération de mondes combinant des composants de la famille Gemini. Sa fiche indique que Gemini Omni Flash ancre les simulations dans l’apparence et le comportement du monde réel, tandis que les modèles Gemini raisonnent pour aider à préserver cohérence et continuité. L’entrée comprend texte, images et actions utilisateur en direct ; la sortie est une vidéo avec audio synchronisé. Ce sont les descriptions du produit et de la documentation par Google, pas une mesure indépendante de la fidélité de simulation. Fiche du modèle Genie 4 · Guide de démarrage Interactions API
La différence avec la génération vidéo hors ligne se trouve dans la boucle interactive. Un générateur vidéo peut produire un clip après une invite. Genie 4 continue de produire des images pendant que l’utilisateur pilote son déplacement ou modifie le décor. La documentation de l’API cite les mondes pilotables en temps réel, les prototypes visuels jouables et l’exploration spatiale interactive. Google dirige les clips hors ligne, le montage, l’extension et l’agrandissement de résolution vers un autre modèle Gemini Omni. Pour les agents vocaux en temps réel, l’entrée microphone et les outils, il renvoie vers Gemini Live. La distinction compte, car générer du son ne signifie pas que le modèle de monde entend la voix de l’utilisateur. Le décor peut contenir un dialogue généré alors que l’entrée reste texte, image initiale ou commande clavier. Guide Google de choix du modèle
Le texte et l’image amorcent le flux en direct#
Une session commence par un événement world_setup, qui peut contenir une description textuelle, une image de référence 16:9 ou les deux. Le développeur peut ensuite envoyer des événements user_action pour les déplacements et contrôles caméra natifs comme WASD et les flèches, ainsi que des événements texte input pour modifier la scène en cours. Le service produit une vidéo de 1280 × 720, jusqu’à 24 images par seconde, accompagnée d’un son stéréo à 48 kHz. L’annonce de Google cite comme exemples le changement de météo, l’ajout d’un personnage ou la redirection d’une action en cours d’exploration. Pour prototyper une scène interactive, c’est plus direct que d’assembler plusieurs clips hors ligne séparés. Protocole d’événement et format de sortie de l’API · Annonce développeur de Google
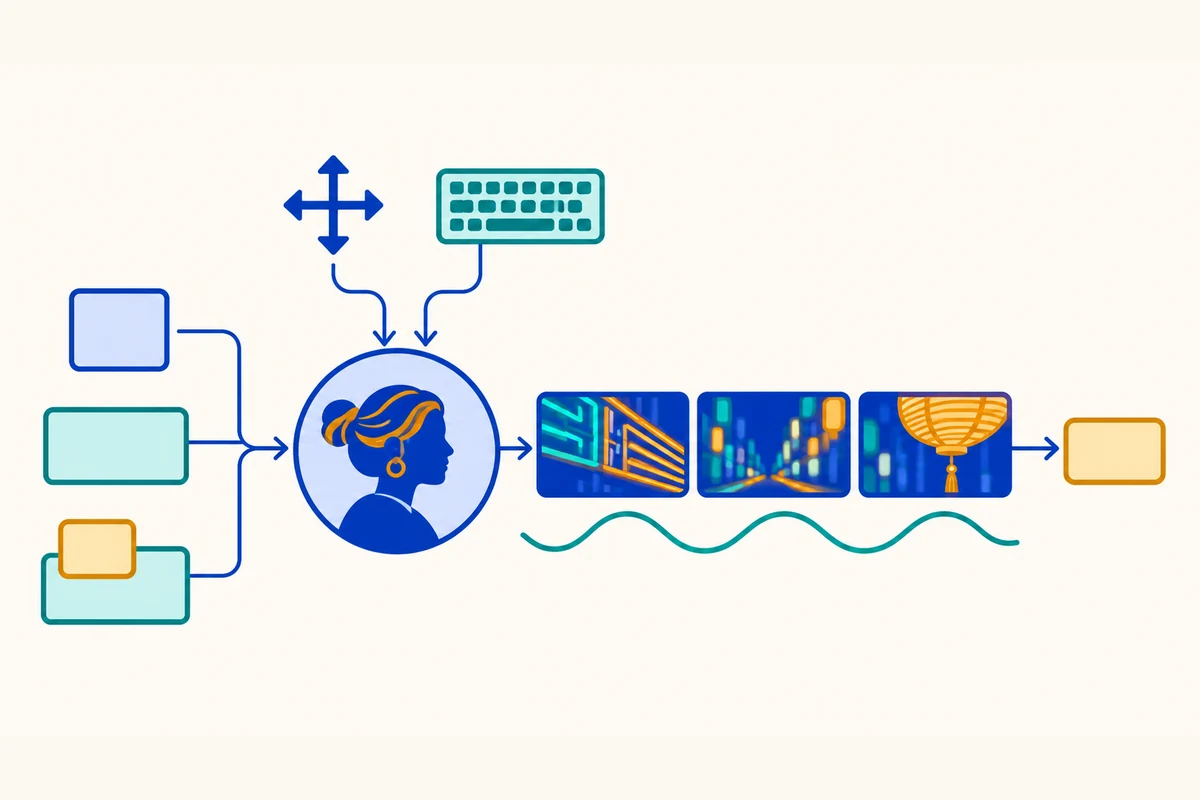
L’interaction possède deux rythmes. Selon la documentation de Google, à faible latence réseau aller-retour, les commandes clavier et caméra peuvent modifier l’image en 0,2 à 0,5 seconde environ. Les invites textuelles qui changent le décor traversent une étape de planification et peuvent prendre une à deux secondes. L’installation initiale peut demander cinq à neuf secondes avant la première image. Ces durées décrivent le workflow documenté à faible RTT, pas un engagement de service valable dans toute région et toute application. Il faut distinguer les commandes de mouvement rapides des changements sémantiques plus lents lors de la conception d’une expérience réactive. Délais d’interaction documentés par Google
Deux transports sont disponibles. WebRTC est recommandé pour les navigateurs, qui décodent directement les pistes média et peuvent utiliser une mémoire tampon anti-gigue. Les scripts Python et Node.js, la capture d’images et les pipelines personnalisés peuvent passer par WebSocket, avec vidéo et audio sous forme d’événements encodés. Google signale davantage de surcharge avec WebSocket et un risque de blocage en tête de ligne TCP en cas de perte de paquets. Les canaux de données WebRTC imposent une limite de 64 Ko aux messages de contrôle ; la documentation conseille de limiter les images de référence encodées à 48 Ko ou de choisir WebSocket pour les images plus volumineuses. Le transport modifie la complexité de l’intégration et le comportement de la latence. Comparaison Google entre WebRTC et WebSocket
Dans un navigateur, la clé API persistante doit rester côté serveur. L’exemple de Google crée l’interaction dans un backend puis émet un jeton éphémère limité à cette interaction. Le navigateur reçoit ce jeton de courte durée et se connecte via WebRTC ou WebSocket. Le développeur peut ainsi garder la clé permanente hors du code client. Création de session, portée du jeton, fin correcte et comptabilisation deviennent des éléments de sécurité applicative. Conseils de Google sur les jetons éphémères
L’audio généré est une sortie synchronisée. Google indique pouvoir produire de la musique, des ambiances et des dialogues interactifs avec le monde. La documentation actuelle diffuse l’audio dans le flux de sortie, mais précise que Genie 4 n’accepte pas d’entrée microphone ou webcam en direct. Les entrées documentées sont le texte, une seule image initiale et les commandes clavier ou caméra. L’API ne prend pas non plus en charge les appels de fonctions, le grounding Google Search ou les sorties structurées. Le développeur peut ajouter des contrôles autour du flux, mais le endpoint de génération de mondes ne réalise pas ces fonctions d’agent. Limites de Genie 4 dans la documentation API
Une facturation à la seconde fait de la fermeture un contrôle de coût#
Genie 4 exige une clé Gemini API payante. La documentation précise 240 tokens vidéo de sortie par image, soit 5 760 tokens par seconde à 24 images par seconde, et environ 0,10 dollar par seconde avec l’audio stéréo inclus. Au tarif publié, une minute de génération revient à environ 6 dollars et une session complète de deux minutes à environ 12 dollars, hors reprises et coûts applicatifs. La facture exacte dépend de la durée générée et du barème applicable. Pour un flux continu, lancer une session au chargement d’une page ou laisser tourner le modèle lorsque l’utilisateur est inactif peut faire grimper les coûts plus vite que prévu. Documentation de facturation Genie 4 par Google
La fin de session relève donc de la maîtrise des coûts autant que de la gestion des connexions. L’API distingue l’arrêt complet de l’interaction de la déconnexion du client local. session.complete() demande au serveur d’arrêter la génération du monde et la facturation des tokens. Fermer l’onglet ou détacher le client coupe le transport sans interrompre immédiatement la génération côté serveur. Une application devrait explicitement terminer la session à la sortie, à la fermeture de la page ou après une durée d’inactivité. Si elle laisse des interactions ouvertes, les frais peuvent continuer après que l’utilisateur croit l’expérience terminée. Documentation Google sur le cycle de session
La région du serveur influe également sur la réactivité. Google indique que Genie 4 est actuellement servi depuis des centres de données américains et qu’une latence réseau aller-retour supérieure à 150 ms ralentit visiblement le pilotage au clavier. Un navigateur situé en Europe ou en Asie peut ressentir des contrôles plus lents même si le modèle fonctionne comme prévu. Les développeurs devraient tester WebRTC depuis la région cible et décider si un relais en Amérique du Nord est pertinent. C’est particulièrement important pour les interactions demandant des réflexes. Conseils de Google sur la région et la latence
Une tarification à la seconde modifie aussi la comparaison des tests. Un prototype générant quelques secondes de décor peut coûter peu. Une exploration jusqu’au plafond, des redémarrages après dérive ou plusieurs sessions laissées ouvertes peuvent vite alourdir la facture. Le coût par session doit inclure initialisation, reprises, inactivité et génération média, pas seulement le temps passé à appuyer sur les touches. Une équipe peut fixer un budget par session, afficher le temps restant et fermer l’interaction côté serveur. Ces choix produit sont nécessaires pour maîtriser un flux continu facturé à l’usage.
Le monde est généré sur un horizon temporel roulant#
Genie 4 génère des images interactives ; il ne maintient pas un graphe de scène 3D persistant à états d’objets déterministes. Google indique que les images suivantes sont conditionnées par les actions et les invites. Sa documentation prévient que des repères, portes ou boutons peuvent changer de place ou se réinitialiser après plus de huit secondes hors champ, un tour complet ou plusieurs modifications complexes. La stabilité visuelle peut se dégrader après 60 à 90 secondes, avec un plafond strict de 120 secondes. Pour un prototype court, cela peut suffire. Pour une simulation de plusieurs minutes supposant que chaque objet reste à ses coordonnées, c’est une contrainte majeure. Limites Google sur la cohérence du décor
Le plafond d’une à deux minutes définit aussi ce que « monde » signifie dans cette interface. Une scène peut sembler continue alors que le système prédit chaque nouvelle image à partir d’une fenêtre temporelle roulante. Un objet réapparaissant après être sorti du champ peut avoir changé d’état. La séquence reste plausible d’image en image sans pour autant satisfaire un test d’état persistant. Une courte expérience cohérente ne prouve donc pas une mémoire longue. La fiche Google cite également la persistance des objets, les interactions physiques complexes, la précision audio, le texte lisible, la précision spatiale et la cohérence à long terme parmi les domaines encore étudiés. Limites de la fiche Genie 4 · Limites détaillées dans l’API
Les invites textuelles n’ont pas la même latence que les commandes de déplacement. À faible RTT, WASD et les flèches peuvent modifier l’image en moins d’une demi-seconde. Une instruction textuelle traverse la planification du monde et prend davantage de temps. Cela suggère un schéma : garder le clavier pour le mouvement continu et le texte pour les changements sémantiques majeurs. Cela signifie aussi que toute invite ne doit pas être conçue comme un bouton instantané dans un jeu traditionnel. L’API donne accès aux deux contrôles, mais à des échelles de temps différentes. Délais d’interaction documentés par Google
Le texte lisible et le nombre exact d’objets connaissent aussi des limites. Google indique que panneaux, compteurs et horloges peuvent se déformer, et que les décomptes exacts varient avec les mouvements de caméra. Le texte n’apparaît souvent clairement que s’il figure dans la description initiale du monde. Un prototype spatial reposant sur des étiquettes, un tableau de bord, un nombre fixe d’objets ou des mesures exactes doit donc ajouter une vérification. Un rendu plausible ne remplace pas l’état exact exigé par l’application. Un utilisateur peut aimer la scène alors que le système échoue à une tâche nécessitant une information précise.
Les entrées ont également des frontières de sécurité. La documentation indique que des invites ou images de référence contenant des personnes identifiables, des personnalités publiques ou de la propriété intellectuelle de marque peuvent être bloquées au démarrage ou interrompre un flux actif. L’annonce produit précise que vidéo et audio générés portent un watermark SynthID et que les entrées et sorties passent par un filtrage de sécurité. Cela influe sur ce que le développeur peut construire et sur la gestion d’une session interrompue. Il vaut la peine de tester ces parcours avec des cas limites bénins, au lieu de supposer que chaque invite que l’application juge anodine sera acceptée. Google sur les entrées et la sécurité · Déploiement et watermarking annoncés par Google
Un modèle de monde ne constitue pas une pile de simulation complète#
Google évoque le cinéma, la conception spatiale, l’apprentissage interactif et l’entraînement d’agents ou de robots comme usages possibles de la génération de mondes. Ce sont des pistes plausibles, mais un décor réaliste ne suffit pas pour un environnement d’entraînement. Un agent simulé doit aussi recevoir des actions de façon cohérente, conserver l’état des objets, suivre des règles causales utiles et produire des résultats adaptés à la tâche. Les limites propres à Genie 4 identifient les interactions physiques, la précision spatiale, la causalité et la persistance comme des sujets encore en recherche. Ces lacunes comptent davantage lorsque les conséquences d’une décision simulée augmentent. Usages visés et limites selon Google
La recherche indépendante sur l’évaluation des modèles de monde souligne cette distinction. Publié avant l’ouverture de l’API en novembre, WMEval compare des modèles interactifs à des simulations Unity en rejouant les mêmes séquences d’actions. Ses neuf scènes testent la contrôlabilité, la cohérence des objets et personnages, la mécanique, les fluides, les chaînes causales et l’éclairage. Les auteurs montrent que la ressemblance visuelle peut masquer un écart d’état physique ou de causalité. L’article évalue « Project Genie » disponible à l’époque ; il ne constitue pas un score du Genie 4 API publié en novembre. Son intérêt ici est méthodologique : associer un monde généré à une référence et vérifier l’état, pas seulement l’apparence. Article WMEval
Cette approche est utile avant de connecter un modèle de monde à un agent en aval. Un développeur peut définir un trajet reproductible, vérifier le contrôle caméra, observer si un objet reste à la place attendue et noter comment l’état évolue après une modification. Pour la robotique, il faut savoir si les trajectoires générées conservent assez de grandeurs physiques et de relations causales pour l’expérience prévue. Pour un prototype créatif, la réactivité visuelle et l’atmosphère peuvent compter davantage que la fidélité mécanique. Chaque usage requiert des critères d’acceptation différents.
WMEval montre aussi pourquoi une seule métrique perceptuelle ne suffit pas. Une vidéo peut ressembler à sa référence alors que la mécanique ou les objets ont divergé ; une simulation cohérente peut avoir une apparence différente. Le protocole combine états dérivés du simulateur et mesures perceptuelles. Il n’évalue pas la version API sortie en novembre, mais illustre le type de preuve indépendante à obtenir avant de qualifier un modèle de monde de simulateur fiable. Méthode de WMEval
Le contrat API est plus étroit qu’un agent temps réel#
Les développeurs doivent distinguer l’API interactive de Genie 4 des autres surfaces Gemini. Genie API crée et diffuse un monde. Sa documentation dirige vers Gemini Live pour les agents vocaux temps réel, la compréhension du microphone et de la caméra, les outils et le grounding par Google Search. Cette distinction évite une confusion de catégorie : la génération audio-native signifie que le monde peut émettre un son synchronisé, pas qu’il entend un appelant ou une webcam en direct. Le monde peut contenir un dialogue généré alors que l’utilisateur saisit du texte, une image initiale ou des actions clavier. Guide Google pour choisir entre Genie, Omni et Live
De même, une invite textuelle au milieu d’un monde n’équivaut pas à un appel d’action structuré. Les limitations documentées excluent les appels de fonction, sorties structurées, entrées microphone ou webcam en direct et reprise de session terminée. Un développeur peut intégrer le flux généré à une application plus large, mais aura besoin d’un autre modèle ou d’une logique déterministe pour consulter des données externes, exécuter des transactions ou conserver un état durable. C’est une architecture possible pour un prototype, à condition de préciser les frontières avant de définir les attentes produit.
Le contrôle d’accès mérite attention. L’exemple navigateur crée l’interaction côté serveur puis émet un jeton éphémère limité à cette session. La clé permanente reste sur le backend et le navigateur ne reçoit que le jeton temporaire. Il faut appliquer le même modèle plutôt que d’insérer une clé durable dans le client. Création de session, portée des jetons, fin d’interaction et comptabilisation des usages font partie de l’architecture de sécurité. Conseils Google pour les jetons éphémères
AI Studio réduit le coût d’entrée grâce à son canvas interactif et ses applications de démarrage. L’API permet de connecter le flux à une interface et à une instrumentation personnalisées. Une équipe peut d’abord découvrir les effets des invites, du déplacement et du son dans le canvas, puis bâtir une expérience API avec une séquence d’actions scriptée. Les critères de test devraient rester identiques entre ces étapes. Une session convaincante dans Studio est utile à l’exploration ; une décision de production demande des mesures sur le transport, la région réseau, la durée de session et le parcours réel de l’utilisateur. Annonce développeur Google et canvas AI Studio
Quelles preuves justifieraient un prototype#
Un premier test utile peut rester court. Définir une scène par texte et image, puis une trajectoire répétable avec quelques mouvements, une invite de modification et le retour à un point déjà vu. Mesurer le temps jusqu’à la première image, la latence des commandes clavier, le délai de modification textuelle et le coût de génération. Vérifier la stabilité des repères et objets tout au long du parcours, puis répéter dans les conditions réseau des utilisateurs visés. Ce protocole répond séparément aux questions d’entrée, de pilotage et d’état avant la construction d’une application complète.
La fermeture de session doit faire partie du test initial. Enregistrer quand complete() arrête la génération serveur, ce qui se passe lors d’une déconnexion et si un client expiré laisse une interaction active. La fermeture d’onglet peut détacher le transport sans terminer la facturation. Le backend devrait définir une durée maximale et clore les travaux abandonnés. Suivre les secondes de génération par utilisateur, les répétitions d’invite et les sessions inachevées aide à transformer un prototype prometteur en coût prévisible, ou à constater qu’il est trop cher pour l’usage visé.
Pour un outil de conception ou d’apprentissage interactif, définir la valeur selon un résultat observable. Les modifications apparaissent-elles assez vite ? L’apprenant comprend-il les changements d’état ? Le concepteur peut-il conserver les caractéristiques visuelles qui doivent rester fixes ? Si le produit exige texte exact, nombre d’objets précis ou longue continuité, il faut tester ces besoins directement. La documentation cite déjà dérive, rendu du texte et durée limitée. Le prototype devrait vérifier ces contraintes pour le cas d’usage plutôt que les déduire d’exemples vidéo.
Pour l’entraînement d’agents ou de robots, le niveau d’évaluation est plus élevé. Il faut comparer les trajectoires à un simulateur ou à des résultats contrôlés, répéter les actions et inspecter les échecs physiques et d’état. Il faut aussi mesurer le transfert de l’agent d’un environnement généré vers un simulateur externe ou un système réel. Google cite l’entraînement d’agents et la robotique comme applications possibles. La documentation et l’API interactive ouvrent une voie d’expérimentation, mais ne résolvent pas la question du transfert ; une évaluation indépendante reste indispensable.
La sortie de l’API change la voie d’accès des développeurs. Elle réduit la friction pour tester et bâtir des expériences autour de Genie 4, et transforme la génération continue de mondes en session à état et à coût mesuré. Les développeurs ont plusieurs transports, des commandes en direct, de l’audio synchronisé et un canvas AI Studio. Ils assument aussi clé payante, gestion de session serveur, région américaine, horizon court et dérive visuelle ou physique. Un prototype bien délimité peut établir si l’ensemble est utile. Les affirmations plus larges sur simulation, robotique ou mondes persistants nécessitent des preuves au-delà de la démonstration de lancement.