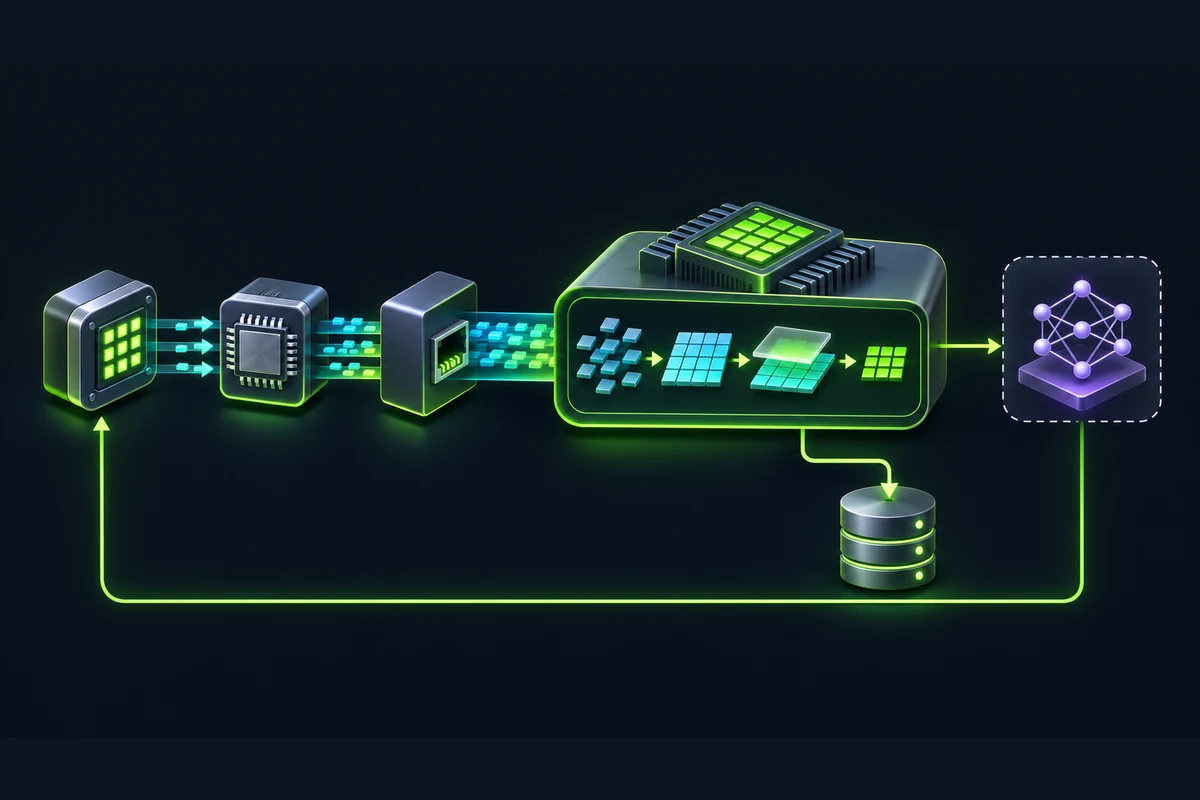
19 ноября NVIDIA описала камеру электронной микроскопии с расширенным динамическим диапазоном в Molecular Foundry при Национальной лаборатории имени Лоуренса в Беркли. Камера подключена к GPU через библиотеку сбора данных NVIDIA DAQIRI. Во время измерения потери энергии электронов прибор передаёт больше 500 гигабит в секунду; компания заявляет, что это более чем в 500 раз быстрее традиционного потока EELS. FPGA считывания отправляет данные по Ethernet к сетевому адаптеру ConnectX; DAQIRI помещает полезную нагрузку в доступную GPU память, где кадры собираются, корректируется детектор, сокращаются спектры и визуализируются результаты, пока эксперимент продолжается. NVIDIA также объявила аппаратное упорядочивание пакетов, backend ibverbs и прямой polling для малозадержанной передачи команд. Отчёт NVIDIA о DAQIRI и микроскопии
Основное изменение касается расположения вычислений. В обычном процессе прибор собирает сырьё, записывает его, затем отправляет на рабочую станцию или вычислительный центр. При очень высокой скорости хранения и передача задерживают обратную связь или заставляют отбрасывать и сокращать данные до того, как исследователи узнают, что важно. DAQIRI помещает GPU память внутрь тракта сбора. Так ПО может анализировать и сокращать данные во время опыта, возможно изменяя настройки до следующего решения о сборе. Потенциал важен, но необходимо отделять то, что показано в примере Беркли, от возможностей платформы, которые пока не являются наблюдённым результатом AI.
Детектор создаёт задачу тракта данных#
Электронная спектроскопия потерь энергии, EELS, измеряет потерю энергии электронов при взаимодействии с образцом. Полученные спектры помогают определять присутствующие элементы и их связи. Сигналы могут быть сильными и слабыми. По описанию NVIDIA, классический подход быстро выполняет два процесса сбора, отдельно оптимизированных для разных уровней интенсивности. Это требует точной координации электронной оптики, экспозиции и считывания детектора; затем результаты выравнивают и объединяют, что усложняет сбор и обработку. Камера с высоким динамическим диапазоном захватывает широкий диапазон за один сбор, упрощая оптику и синхронизацию, но резко повышая объём данных за единицу времени. NVIDIA о рабочем процессе камеры EELS
Больше 500 Гбит/с — не только сетевой лозунг. Деление на восемь даёт минимум 62,5 гигабайта в секунду, пока поток активен. Если бы такая скорость поддерживалась непрерывно, это было бы примерно 225 терабайт в час и 5,4 петабайта в сутки, до учёта протокольных расходов и сокращения данных. Эта арифметика показывает, почему схема «сохранить всё и посмотреть позже» может стать непрактичной. Она не означает, что микроскоп работает с такой скоростью целые сутки. Сбор может идти отдельными сериями, а последующая обработка — сокращать объём или отбирать данные для сохранения.
Камера, FPGA считывания, линии Ethernet, сетевой адаптер и ПО образуют одну систему сбора. Данные детектора полезны лишь тогда, когда следующие этапы принимают их без потерь, восстанавливают структуру кадров и успевают вычислить результат до следующего шага опыта. Если линия теряет пакеты или переполняются буферы, GPU не восстановит пропущенное измерение. Если данные целы, но пришли не по порядку, их надо отсортировать до сборки осмысленных кадров. Если обработка начинается только после долгой записи на диск, вывод может опоздать к решению, на которое должен был повлиять.
Перемещение данных становится частью экспериментального дизайна. Учёные обычно выбирают экспозицию, сканирование и область интереса заранее, исходя из образца и детектора. Новая камера с высоким динамическим диапазоном может одновременно показать детали, ранее скрытые или требовавшие отдельных проходов. Но дополнительные сведения полезны, только если тракт сбора выдаёт результат вовремя. Вопрос не только в том, соберёт ли камера больше, но и получат ли исследователи эти данные, пока ещё могут изменить следующее измерение.
В лаборатории Беркли есть похожий пример, но с другим прибором и трактом данных. По описанию лаборатории, камера 4D Camera работает со скоростью 87 000 кадров в секунду и создаёт до 700 ГБ данных за 15 секунд. В существующей системе FPGA подключены к серверам приёма, данные сначала попадают в RAM, затем на flash, после чего обрабатываются локально или передаются в NERSC. Лаборатория говорит, что потоковая система сократила время обработки и позволила принимать решения в реальном времени. Это показывает ценность быстрой микроскопии, но не должно смешиваться с новой EELS-камерой на 500 Гбит/с или трактом DAQIRI. Рабочий процесс Berkeley Lab с камерой 4D · Министерство энергетики США о реальном времени для данных детекторов
Новая система меняет место, где выполняется дополнительная обработка. Запись на flash и перенос в централизованные вычислительные ресурсы остаются полезными для архива и больших расчётов. Тракт DAQIRI позволяет выполнить отдельные операции на краю до или во время этих шагов. Это дополняющая архитектура, а не простая замена дисков и HPC. Исследователям может понадобиться сырое архивное измерение для повторного анализа, а также оперативное сокращение, чтобы сразу менять параметры. Решение о хранении, сокращении и удалении зависит от научной воспроизводимости и плана опыта.
DAQIRI направляет тракт сбора к GPU#
DAQIRI означает Data Acquisition for Integrated Real-time Instruments. NVIDIA описывает библиотеку как программный слой, который передаёт высокоскоростные данные приборов и сенсоров в готовые GPU-процессы. На совместимом оборудовании она работает с сетевым адаптером напрямую в пользовательском пространстве, минуя сетевой стек ядра Linux, и применяет GPUDirect для передачи между NIC и GPU без промежуточной копии через CPU. API поддерживает C++ и Python. DAQIRI входит в Holoscan — экосистему для потоковой обработки сенсоров и приложений AI реального времени. Репозиторий и документация NVIDIA DAQIRI · Обзор DAQIRI для разработчиков
«GPU-native сбор» не означает, что GPU заменяет микроскоп или всю электронику считывания. В примере Беркли камера и FPGA по-прежнему собирают и форматируют данные детектора. Ethernet передаёт пакеты на совместимый NIC. DAQIRI отвечает за транспортировку, порядок и размещение памяти. GPU-ядра затем собирают кадры и корректируют детектор перед преобразованием в спектры EELS. По словам NVIDIA, вычисления позволяют извлечь субмикронные пространственные сведения из сенсорных пикселей шириной пять микрон. Система состоит из нескольких специализированных частей, а DAQIRI соединяет измерение с ускоренной обработкой.
Понятие «zero-copy» тоже имеет границы. Оно означает отказ от лишних копий в совместимом тракте, например прямую запись сетевой полезной нагрузки в память, доступную GPU. Это не отменяет буферизацию, разбор пакетов, перестановку, коррекцию детектора, преобразования и последующее хранение. Некоторые этапы могут намеренно копировать или преобразовывать данные, а режим передачи зависит от того, используется ли дискретный GPU или унифицированная память. Zero-copy способен уменьшить нагрузку на CPU и память, но сквозная скорость всё равно зависит от GPU-ядер, формата детектора, очередей, сетевого трафика и планирования ПО.
Поддержка оборудования ограничена конкретными конфигурациями. По репозиторию DAQIRI, высокопроизводительные пути Raw Ethernet, RoCE и GPUDirect требуют NIC NVIDIA ConnectX-6 Dx или новее и поддерживаемого CUDA GPU. Среди платформ названы DGX Spark, IGX и RTX Pro Servers. Обычный путь Linux sockets может работать на более скромном оборудовании, но не обеспечивает тот же максимум производительности. Текущая инструкция конфигурации указывает, что pacing пакетов, точная передача по времени и аппаратная перестановка требуют ConnectX-7 или новее. Поэтому GPU-native — архитектурный вариант для совместимых систем, а не программное ускорение любого компьютера. Требования DAQIRI · Настройка оборудования DAQIRI
Тракт данных отличается на системах с дискретным и интегрированным GPU. Документация NVIDIA описывает IGX с дискретным GPU, отдельным GPU BAR1 и связью PCIe между NIC и GPU. DGX Spark на базе GB10 использует унифицированную память CPU/GPU и встроенный ConnectX-7; для GPUDirect в описанной схеме нужны буферы host-pinned. Это важно учитывать при чтении тестов. Похожие заявления «напрямую в GPU» могут скрывать разные топологии и способы передачи с разными задержкой и пропускной способностью.
Поведение меняют и параметры ПО. DAQIRI поддерживает Raw Ethernet, RoCE/RDMA и Linux Sockets, несколько движков приёма, переупорядочение на CPU или GPU и разные варианты памяти. Разработчик конфигурирует интерфейсы, очереди, потоки и области памяти. Выпуск не предлагает одного режима, который автоматически делает любой поток реального времени. Нужно выбрать транспорт и очередь под прибор, настроить хост и сеть, проверить потери, давление на память и всю цепочку под настоящей нагрузкой. Вводная документация NVIDIA рекомендует собрать библиотеку, при необходимости настроить хост и запустить бенчмарк на целевой системе. Начало работы с DAQIRI · API-гид DAQIRI
Три обновления направлены на разные узкие места#
Ноябрьский выпуск добавляет аппаратную перестановку пакетов для поддерживаемых сетевых карт ConnectX-7 и новее. Пакеты могут приходить не по порядку, а обычная программная обработка добавляет нагрузку CPU, память и задержку. В совместимых форматах NIC разбирает поля последовательности и укладывает полезную нагрузку в нужное место памяти. Приложение получает уже упорядоченный буфер без отдельной программной перестановки и копирования. Конфигурация должна знать, где находится последовательность, и что делать при пропущенном пакете. Это функция конкретной очереди, а не гарантия отсутствия потерь или поддержки формата каждого прибора. Описание аппаратной перестановки NVIDIA
Вторая функция — движок ibverbs для высокоскоростной передачи сырых Ethernet-пакетов. По данным NVIDIA, он уменьшает затраты CPU на пакет и почти удваивает пропускную способность на ядро относительно прежнего backend DPDK по умолчанию при пакетах до 1 024 байт и скоростях выше 200 Гбит/с. Бенчмарки проводились на DGX Spark, IGX Thor и RTX Pro Servers. На рисунке 3 показан результат одной очереди на IGX Thor; для DGX Spark и x86 ожидаются похожие показатели. На пакетах 8 КБ скорость была близка. Выигрыш зависит от размера пакетов и условий сравнения, а не означает удвоение любой общей полосы. Условия теста ibverbs NVIDIA
Третья функция — direct polling — предназначена для чувствительного к задержке управляющего трафика. Обычный I/O worker отдельно от потока приложения отправляет и получает пакеты, создавая передачу между потоками. Direct polling позволяет самому приложению выполнять отправку и приём. NVIDIA сообщает о 2–4 микросекундах от отправки до получения в проводном loopback-тесте между портами одного хоста. Это локальный сетевой микробенчмарк, не полная задержка от камеры через GPU-анализ до команды прибору. Полный путь содержит считывание детектора, пакетизацию, планирование, GPU-вычисление, решение и ответ устройства. Микросекунды относятся только к одному звену. Описание direct polling-теста NVIDIA
Функции можно сочетать выборочно. Для высокоскоростной очереди измерений применять аппаратную перестановку, для небольшой очереди управления — direct polling. Пакетная обработка данных оптимизирует пропускную способность, а критичные управляющие сообщения идут отдельно. Так учитываются две разные задачи: эффективно принять большой поток и вовремя отправить команду. Оптимизация одной может мешать другой, поэтому обе нужно измерять при реальной конкуренции, а не принимать минимальную задержку за производительность всей системы.
EELS-кейс показывает обработку изображения, не доказанную AI-петлю#
NVIDIA позиционирует DAQIRI как инфраструктуру для AI реального времени в научных приборах, поддерживающую анализ и обратное управление. Кейс EELS из Беркли описывает скоростной сбор и GPU-обработку во время измерения. Названы такие операции GPU, как сборка кадра, коррекция детектора, сокращение спектра и визуализация. В статье не указана AI-модель, автономно управляющая микроскопом, и не приводятся показатели точности AI или автоматического контроля для этой камеры. Кейс Беркли от NVIDIA
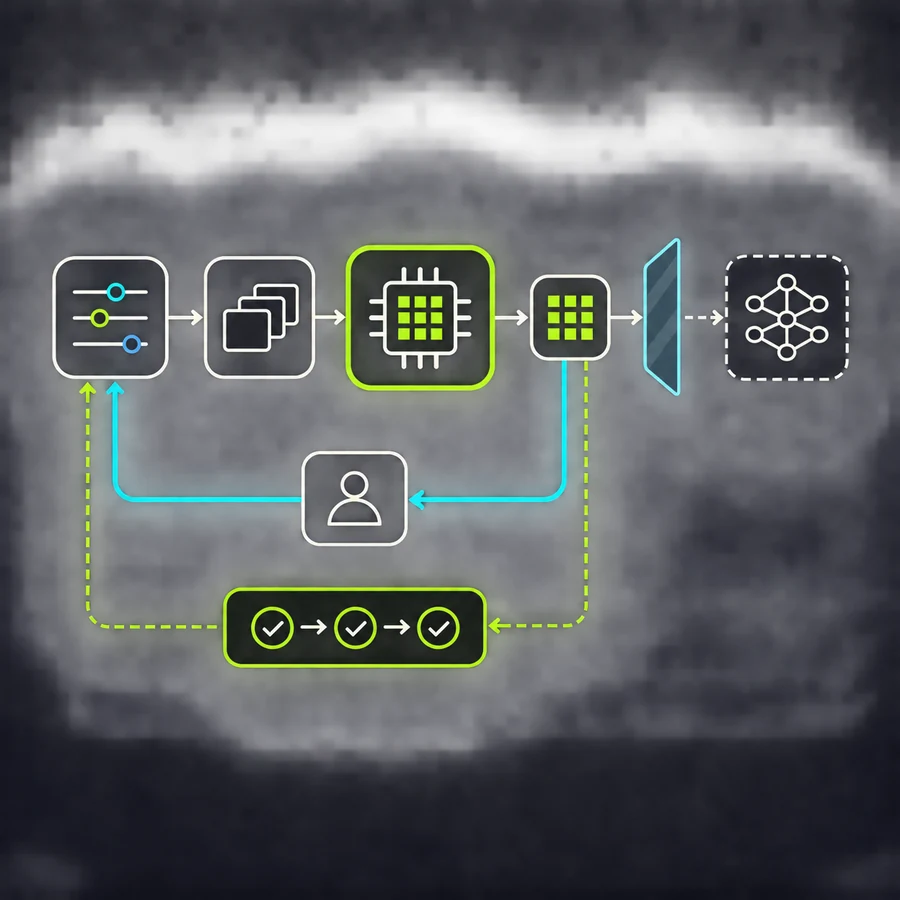
Это различие важно, потому что GPU-цепочка не равна инференсу AI-модели. GPU-ядра могут выполнять детерминированную коррекцию, преобразование и сокращение данных без модели. Holoscan и TensorRT могут запускать последующие потоковые AI-приложения; DAQIRI готовит им входные данные. Рассказ NVIDIA о платформе состоит в том, что тракт сбора делает real-time AI возможным. В описанном EELS-примере сообщается о возможности обрабатывать и просматривать данные во время сбора. Для заявления о научном открытии или изменении эксперимента с помощью AI нужны отдельное описание и доказательства.
Это также уточняет смысл обратной связи. Во время измерения исследователи могут просмотреть данные, поменять параметры или области интереса. Это возможность работы с человеком в контуре. Автономная петля требует дополнительно определить состояние, решить, какую настройку изменить, безопасно применить её и проверить следующее измерение. В блоге обсуждаются обратная связь и чувствительное к задержке управление, но EELS-кейс не описывает AI-систему, которая самостоятельно выбирает, как вести микроскоп. Архитектура может помочь создать её, но публикация этого ещё не демонстрирует.
Сравнение «более чем в 500 раз быстрее традиционного EELS» также является заявлением NVIDIA о сравниваемых потоках данных. В статье объясняется, что традиционный метод отдельно оптимизирует сбор сильных и слабых сигналов, но не полностью определены обычный прибор, детектор, длительность сбора и граница обработки, использованные для коэффициента 500. Цифра задаёт масштаб, её нужно приписывать NVIDIA и не выдавать за независимо аудированный отраслевой коэффициент.
Независимые исследования микроскопии показывают, почему быстрая обработка важна давно. Камера 4D Camera в лаборатории Беркли работает на 87 000 кадрах в секунду и создаёт до 700 ГБ за менее чем 15 секунд. Прежний процесс загружал данные в RAM, записывал во flash, затем обрабатывал на месте или передавал в NERSC. Лаборатория сообщает, что потоковая система ускорила обработку и позволила принимать решения во время эксперимента. Статья 2025 года о потоковой микроскопии также описывает проблемы хранения крупных массивов и путь через FPGA, приёмные серверы, память и накопители. Это не измерения новой EELS-камеры или DAQIRI, но они показывают, что скорость детекторов и задержка анализа давно влияют на разработку приборов. Рабочий процесс 4D Camera лаборатории Беркли · Статья о потоковой микроскопии
Новая система меняет расположение дополнительной обработки. Запись на flash и передача централизованным вычислительным ресурсам полезны для архива и больших расчётов. DAQIRI позволяет перенести часть операций на edge до этих этапов или параллельно им. Это дополняющая архитектура, а не простая замена диска или HPC. Исследователям могут одновременно понадобиться исходное измерение для повторного анализа и немедленная редукция для настройки параметров. Решение о сохранении, сокращении или удалении зависит от научной воспроизводимости и плана опыта.
Обработка реального времени меняет ход эксперимента#
Просмотр данных прямо во время сбора может раньше выявить проблему. Неожиданный сигнал, дефект детектора или неверная область интереса могут проявиться до завершения длинного измерения. Польза не только в быстрой постобработке: можно избежать сбора неподходящих данных. Если время на приборе ограничено или образец чувствителен, раннее предупреждение влияет на следующий шаг. Это смысл приближения анализа к детектору.
При этом раннее действие нужно сбалансировать с сохранением доказательств для будущего. Живое сокращение может быстро показать спектр, но исходный поток содержит детали, которые позднее сможет извлечь новый алгоритм. Если данные удаляются ради пропускной способности, план должен объяснять, что и почему было сокращено. Если сырьё сохраняется, требования к диску и сети никуда не исчезают. Подход «обработать до диска» снижает нагрузку некоторых сценариев, но не отменяет управление данными.
Наличие GPU-native сбора может побудить производителей изменить схему считывания. NVIDIA предполагает, что новая камера, одновременно снимающая сильные и слабые сигналы, может упростить оптику и координацию, ранее нужные для двух проходов. Но электроника детектора и FPGA всё равно должны выдерживать поток, а сеть и вычислительная цепочка иметь достаточную ёмкость. Быстрый канал может просто перенести узкое место. Если GPU не успеет собирать кадры или сокращать спектры, очередь вырастет либо сбор замедлится.
Для прибора с обратной связью важнее всего сквозная задержка под нагрузкой. Loopback 2–4 микросекунды недостаточно. Надо измерить путь от события детектора до проверенной научной метрики, затем до решения и ответа прибора. Следует отслеживать jitter и потери, а не только среднюю скорость. Камера может выдавать импульсные потоки, а хвост задержки — критически влиять на управление. Только эти измерения показывают, может ли конвейер безопасно влиять на сбор или он лишь создаёт предпросмотр.
Научная обратная связь требует и предохранителей. Модель не должна менять важные параметры из-за одной необычной картинки. Приложению могут понадобиться порог уверенности, ограничение изменения и подтверждение исследователя. Логи должны хранить исходные данные, вычисленный сигнал, версии ПО и принятое действие. Без происхождения решений быстрая обратная связь может снизить воспроизводимость опытов. Низкая задержка ценна, если раньше даёт свидетельства и сохраняет их проверяемость.
Что показывают цифры производительности, а чего не показывают#
Показатели throughput зависят от размера пакетов, числа очередей, оборудования и версий backend. Результаты ibverbs относятся к производительности на ядро для малых пакетов при скоростях выше 200 Гбит/с, а throughput больших пакетов описан как сходный. Direct polling измеряли проводным loopback между портами одного хоста. Поток камеры Беркли — отдельный прикладной случай свыше 500 Гбит/с. Эти цифры отвечают на разные вопросы и не доказывают, что микроскоп выполняет AI-обратную связь за четыре микросекунды при потоке 500 Гбит/с.
Тестировать следует целевую систему. Инструкция NVIDIA по DAQIRI содержит требования к Linux, допустимые сочетания NIC/GPU, hugepages и CUDA, а также сообщает, что контейнер включает модифицированный DPDK и сетевые зависимости. Пиковый GPUDirect требует совместимого оборудования. Обычный путь Linux socket поддерживает более простой набор устройств, но не является тем же высокопроизводительным трактом. Это влияет на доступность и объём инженерной и закупочной работы. Требования к оборудованию и ПО DAQIRI
Статья NVIDIA рекомендует запускать DAQIRI-бенчмарки для проверки пропускной способности и коммуникационной задержки на конкретной платформе. Хороший тест использует реальные форматы пакетов прибора, порядок доставки, профиль всплесков, GPU-ядра, требования к хранению и частоту обратной связи. Нужно проверить перегрузку и восстановление после пропуска. Аппаратная перестановка зависит от поддерживаемого NIC и формата последовательности; настройка тайм-аута может отбрасывать неполные пакеты. Это вопросы научной полноты, а не одной лишь скорости.
Чистый бенчмарк может сравнить варианты: обычный приём с копированием, GPUDirect, программную и аппаратную перестановку, batch-обработку и direct polling для контроля. Данные детектора и анализ следует оставить одинаковыми, меняя только одну часть. Может оказаться, что сложная аппаратная функция мало даёт на крупных пакетах, или что прямой polling уменьшает задержку, но занимает ядро приложения. Такие результаты полезны; не обязательно по умолчанию включать каждую новую функцию.
Решение о сохранении исходных измерений или обработке на edge следует оценивать отдельно от сетевого throughput. Для некоторых экспериментов достаточно выбранных спектров для немедленной реакции. Другим нужны сырьевые данные для аудита, калибровки или нового анализа. DAQIRI может доставить байты прямо в GPU, но не определить, какие научные свидетельства допустимо отбросить. Эту границу задают план измерений и последующая обработка.
Какие доказательства сделают следующие результаты убедительными#
Наиболее сильным продолжением была бы публикация полного процесса для новой камеры и DAQIRI, включая устойчивый и пиковый потоки, потери пакетов, состояние GPU и накопителей, задержку обработки и объём сохранённого сырья. Сравнение с обычным EELS за заявлением «500 раз» должно определить традиционную конфигурацию и пояснить, что именно сравнивается: выход детектора, собранные кадры или конечные спектры. Тогда другим лабораториям будет легче оценить число.
Для обратной связи с AI нужна отдельная оценка. Следует назвать модель или алгоритм, условие измерения, разрешённое действие и результат по эталону или процессу с человеческим одобрением. Тест должен включать пропуски и ложные срабатывания, необычные образцы. Нужно показать, увеличился ли результат эксперимента или сократилось время без потери данных для дальнейшего анализа. Подготовленный для GPU транспорт не заменяет валидацию научного метода.
Для воспроизводимости нужны подробности ПО и оборудования: версия DAQIRI, NIC и GPU, драйверы и CUDA, очереди, размер пакетов, число повторов, вариации образцов и неопределённость. Также следует различать измерения NVIDIA, команды прибора и независимых исследователей. В нынешней технической заметке много полезных инженерных сведений, особенно о функциях и пути данных; независимые замеры показали бы, насколько результат переносим.
Есть и вопрос экосистемы. DAQIRI открыт по Apache 2.0 и имеет интерфейсы C++ и Python, но максимальная скорость зависит от совместимых сетевых карт и GPU NVIDIA. Сокетный путь работает с другими NIC, высокоскоростные zero-copy режимы ограниченнее. Научные комплексы сочетают старые приборы, собственные FPGA и общие кластеры. Объём интеграции, обработка отказов и долгосрочная поддержка будут влиять на внедрение не меньше ширины канала. Репозиторий DAQIRI и совместимые пути
Путь измерений быстрее, но AI-контур ещё предстоит показать#
Обновление DAQIRI решает конкретную проблему приборов: потоки данных могут перегружать процесс «сначала сохранить, потом проанализировать». Камера EELS из Беркли — конкретный пример, где GPU-native передача позволяет обрабатывать данные при продолжающемся измерении. Аппаратная перестановка, ibverbs и direct polling нацелены на разные узкие места передачи пакетов и контрольных сообщений. Опубликованные результаты зависят от конкретных пакетов, оборудования и условий испытаний.
Связь с AI пока на уровне платформы. DAQIRI может подготовить данные к GPU-обработке, инференсу и обратной связи, но процесс EELS из статьи выполняет сборку кадров, коррекцию детектора, сокращение спектров и визуализацию. В нём не показано, как AI-модель автономно управляет микроскопом. Исследователи могут смотреть данные и менять настройки во время опыта. Это полезно, но отличается от проверенного AI-эксперимента с замкнутым контуром.
За чем стоит наблюдать дальше — улучшит ли этот путь решения о измерениях от начала до конца. Убедительное подтверждение свяжет выход камеры, передачу данных, GPU-анализ и управление с воспроизводимым научным результатом, показав хранение сырья и режимы отказа. Пока DAQIRI следует понимать как инфраструктуру, приближающую анализ к прибору. Конвейер данных направляется к AI; продемонстрированный результат — более быстрый доступ к измерениям.